120 milliárd paraméteres nyílt AI-modellt adott ki az NVIDIA
A Nemotron 3.5 Super VL vállalati ágenseket céloz, a kisebb Bolt modellek pedig helyben, felhő nélkül dolgozhatnak.
▶ 30 MÁSODPERCBEN
- MI TÖRTÉNT
- Az NVIDIA kiadta a nyílt súlyú Nemotron 3.5 Super VL-t és a 24 GB memóriába férő Bolt 74B-A9B modellt.
- MIÉRT FONTOS
- A fejlesztők saját infrastruktúrán futó, szöveget és képet is értő AI-ágenseket építhetnek velük, de a teljesítményelőnyök egyelőre vállalati állítások.
- MI JÖN MOST
- A kisebb, helyi asszisztensekhez szánt Bolt E4B 4GB megjelenését 2026. október 23-ra tervezik.
A 120 milliárd paraméterből egyszerre csak 12 milliárdot használ az NVIDIA új Nemotron 3.5 Super VL modellje. A 2026. október 15-én kiadott rendszer folyamatosan működő, szakosított AI-ágensekhez készült: olyan szoftverekhez, amelyek nemcsak válaszolnak, hanem eszközöket használva feladatokat is végrehajtanak. Mellette egy helyben futtatható Bolt modell is elérhetővé vált, egy kisebb változat pedig október 23-án érkezhet.
Egy modell értelmezi a szöveget, képet és videót
A Super VL multimodális, vagyis többféle bemenetet kezel: szöveget, képet, dokumentumot és videót. Az NVIDIA szerint az érvelést, az utasításkövetést és a külső eszközök meghívását egyesíti. MoE-felépítése miatt a teljes modellnek csak egy része aktív egy-egy számításnál.
Előtanításához és annak folytatásához mintegy 26 billió tokent használtak; ezt körülbelül 3,8 millió mintás utótanítás és több tucat környezetben végzett megerősítéses tanulás követte. A cég szerint a multimodális ágensfeladatokban megközelíti legnagyobb érvelőmodelljének pontosságát, nagyjából ötödannyi paraméterrel.
Erős teszteredmények, vállalati közlésből
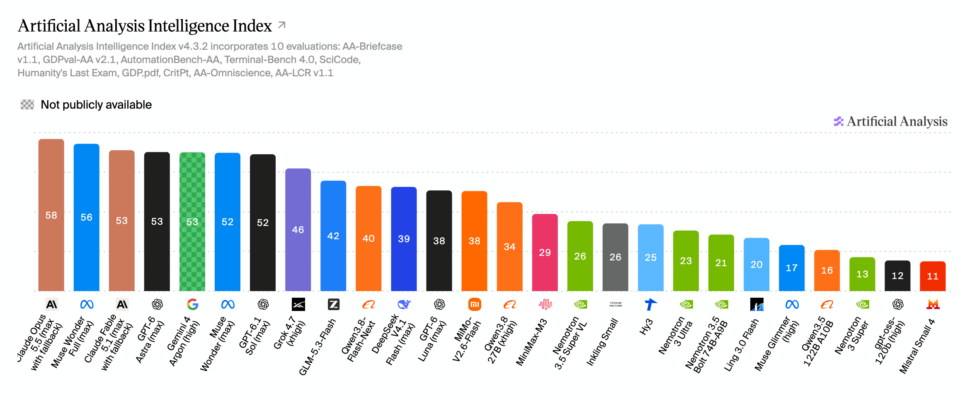
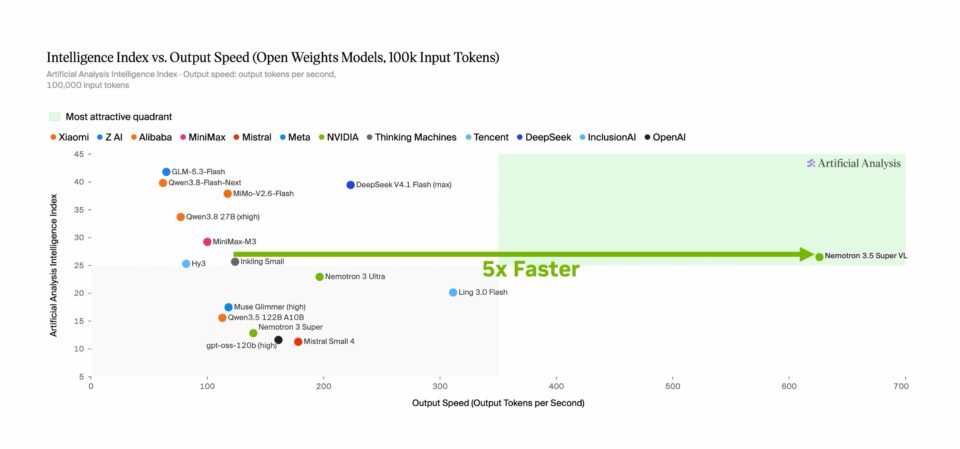
Az NVIDIA blogja a következő legjobb nyílt ágensmodellhez képest ötszörös feldolgozási sebességet állít; az IT之家 legfeljebb ötszörös előnyről ír a hasonló kategóriájú modellekkel szemben, az Artificial Analysis Intelligence Index ranglistájára hivatkozva. Ez nem minden feladatra érvényes gyorsulási garancia.
Az IT之家 által ismertetett NVIDIA-adatok szerint a diagramértelmezést mérő CharXiv teszten 80,8%-ot ért el a Super VL, szemben a Nemotron 3 Nano Omni 63%-ával; Python-kódfuttatással 84%-ra javult. A Hermes Bench eredménye 63,44%, a LangChain viselkedésértékeléséé 87,05%, míg a Nemotron 3 Ultra rendre 56,33%-ot és 84,3%-ot kapott. Ezeket a részletes adatokat a rendelkezésre álló NVIDIA-blogszöveg nem tartalmazza.
A Bolt 24 GB memóriában is elfér
A már elérhető Bolt 74B-A9B 24GB összesen 74 milliárd, egyszerre 9 milliárd aktív paramétert használ. Natív 2 bites kvantálással 24 GB memóriába fér, és NVIDIA RTX/DGX Spark rendszereken felhőbe küldött feladatok nélkül működhet. Támogatja a llama.cpp, vLLM, Ollama, Unsloth és LM Studio eszközöket; az NVIDIA szerint kategóriája nyílt modelljei között első a PinchBench, második a BrowseComp teszten.
Az október 23-ra ígért Bolt E4B 4GB helyi hangasszisztensekhez, interaktív karakterekhez, fizikai környezetben működő ágensekhez és beágyazott kezelőfelületekhez készül. Célplatformjai a GeForce RTX, a Jetson és az RTX/DGX Spark.
Letölthető súlyok, testreszabható vállalati ágensek
Az NVIDIA kiadja a Super VL alap-, utótanított és NVFP4-kvantált modellsúlyait, tanítási receptjeit, valamint Hugging Face-adatkészleteket és NeMo Gym-tanulókörnyezeteket. A nyílt súlyok letölthetők és saját infrastruktúrán futtathatók; a NeMo saját adatos testreszabást, a NIM ellenőrzött konfigurációjú, vállalati támogatású szolgáltatáscsomagot kínál. Az integrálók között van az Atlassian, a CrowdStrike, a Dassault Systèmes, a Perplexity, a Salesforce és a Synopsys.
Az IT之家 további NVIDIA-állításokat is közöl: a LiLiCorr tokenelőállítása DGX Sparkon akár 2,3-szer gyorsabb lehet. Tizenhat B200 gyorsítókártyán, felhasználónként másodpercenként 50 token mellett a Dynamo optimalizált kéréselosztással és gyorsítótár-kezeléssel akár nyolcszor annyi felhasználót szolgálhat ki, 85%-kal rövidebb elsőtoken-várakozással.
A Scale AI Skydance számára testreszabott pénzügyi ágensénél 97,5%-os futtatásiköltség-csökkenést és 80%-os késleltetéscsökkenést várnak. A Ramp nyugtaképekből készít strukturált JSON-adatokat, legfeljebb 50%-kal nagyobb feldolgozási sebességet és 90%-kal kisebb késleltetést várva. Ezek várakozások, nem általánosan garantált megtakarítások.
TECH-SZÓTÁR
- Paraméter
- A modell tanulás során beállított belső értéke, amely befolyásolja a működését.
- MoE
- Olyan felépítés, amelyben egy-egy számításnál csak a modell kijelölt részei dolgoznak.
- Kvantálás
- A modell számainak kisebb pontosságú tárolása, amely csökkenti a memóriaigényt.
- Token
- A modell által feldolgozott vagy előállított szövegegység, például szó vagy szórészlet.
» Követett téma: AI · régió: USA · kulcsszó: nyílt modellek, helyi AI